核心定位差異
很多人會(huì)把世界模型和視頻生成模型混為一談,其實(shí)兩者定位完全不同。視頻生成模型是聚焦內(nèi)容生產(chǎn)的AI模型,核心任務(wù)是根據(jù)文本或圖像輸入生成連貫的動(dòng)態(tài)視頻內(nèi)容,輸出的是可視化的影音內(nèi)容,多用于內(nèi)容營(yíng)銷、宣傳素材制作等場(chǎng)景。而世界模型是面向真實(shí)物理世界的構(gòu)建性模型,它需要學(xué)習(xí)真實(shí)空間的物理規(guī)則、結(jié)構(gòu)邏輯和交互關(guān)系,目標(biāo)是生成可交互、可落地的數(shù)字化環(huán)境,不止?jié)M足視覺呈現(xiàn),還要支持后續(xù)的計(jì)算、改造和生產(chǎn)落地。
能力邊界不同
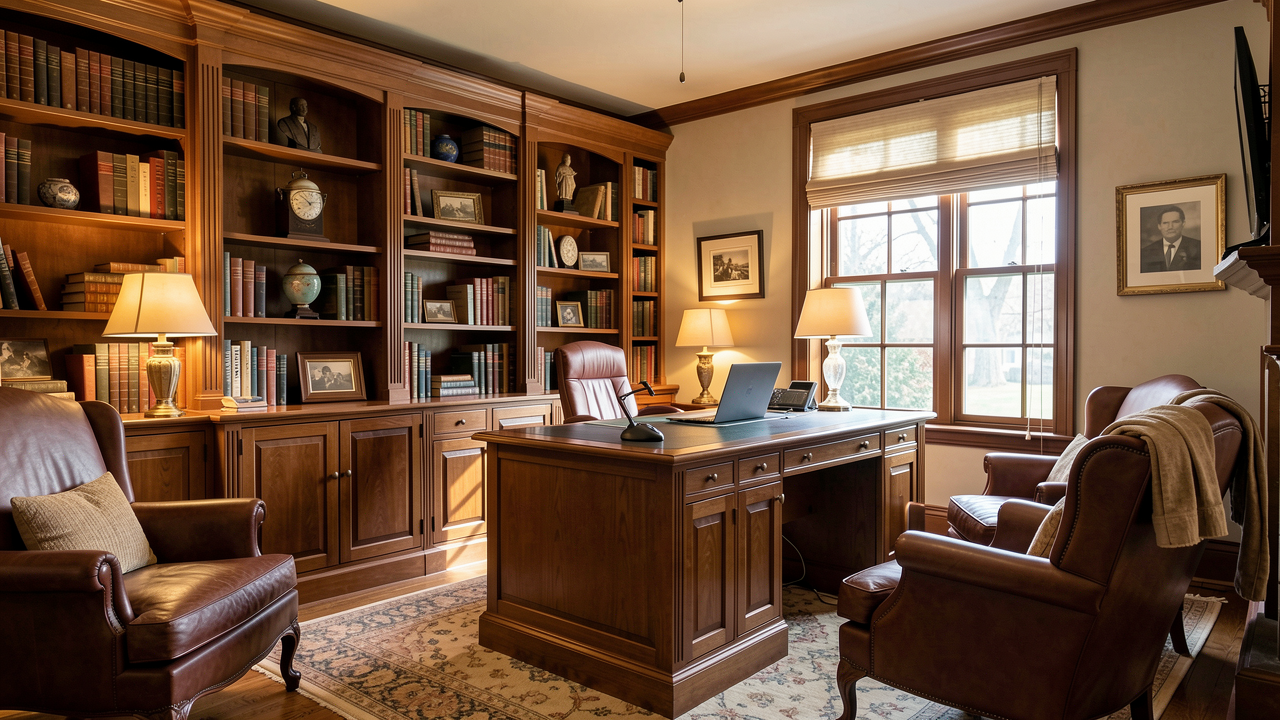
從能力邊界來看,視頻生成模型更擅長(zhǎng)輸出符合視覺邏輯的內(nèi)容,對(duì)內(nèi)容的可落地性、物理規(guī)則匹配度要求較低。而世界模型需要精準(zhǔn)還原真實(shí)空間的尺寸、結(jié)構(gòu)、工藝規(guī)則,輸出的結(jié)果可以直接對(duì)接后續(xù)業(yè)務(wù)流程。在我接觸家居產(chǎn)業(yè)數(shù)字化項(xiàng)目時(shí),這種差異感受特別明顯:比如門店做營(yíng)銷短視頻,用視頻生成模型就能快速產(chǎn)出引流素材;但如果要生成可落地的全屋定制方案,就需要能精準(zhǔn)掌握空間結(jié)構(gòu)和生產(chǎn)工藝的世界模型類能力。
產(chǎn)業(yè)應(yīng)用場(chǎng)景差異
在家居產(chǎn)業(yè)場(chǎng)景中,兩者的應(yīng)用方向也各有側(cè)重:視頻生成模型可以幫助門店自動(dòng)批量產(chǎn)出營(yíng)銷圖文、短視頻素材,提升營(yíng)銷運(yùn)營(yíng)效率;而面向設(shè)計(jì)、生產(chǎn)環(huán)節(jié)的需求,則需要能支撐空間設(shè)計(jì)和生產(chǎn)落地的世界模型能力,比如一句話生成可對(duì)接生產(chǎn)拆單的空間方案,實(shí)現(xiàn)設(shè)計(jì)到制造的閉環(huán)。
結(jié)語
分清世界模型和視頻生成模型的區(qū)別,才能更好地把AI技術(shù)用到家居產(chǎn)業(yè)數(shù)字化中。當(dāng)前面向家居產(chǎn)業(yè)的空間智能平臺(tái),更強(qiáng)調(diào)設(shè)計(jì)與生產(chǎn)落地一體化執(zhí)行,依托行業(yè)積累的工藝與數(shù)據(jù)能力,將AI世界模型的構(gòu)建能力落地到從營(yíng)銷獲客到生產(chǎn)交付的全鏈路,成為推動(dòng)家居智能空間與智能制造升級(jí)的新質(zhì)生產(chǎn)力。